两条路做同一个 bigram:数频次与梯度下降
这一集最妙的设计:同一个 bigram 模型用两种方式实现 —— 先数频次,再用神经网络训练 —— 最后证明两者结果几乎完全一致。
这个对照回答了一个一直悬着的问题:神经网络到底在学什么。
第一条路:数频次
数据与 bigram
32033 个真实英文人名,最短 2 个字母、最长 15 个。
bigram = bi(二)+ gram(元),属于 n-gram 家族:
| 名称 | 看多远 | emma 拆出 |
|---|---|---|
| unigram | 0 | e、m、m、a |
| bigram | 前 1 个 | em、mm、ma |
| trigram | 前 2 个 | emm、mma |
拆分的标准写法:
chs = ['.'] + list(w) + ['.']for ch1, ch2 in zip(chs, chs[1:]): ...zip(chs, chs[1:]) 是取滑动窗口的标准手法 —— 列表和它错开一位的自己配对。
为什么末尾不会多出一对空的:
zip按最短的截断。这里恰好是想要的 —— 结束符只作为「答案」出现,不作为「输入」。同一个行为在第五篇的Neuron.__call__里却是个隐患(输入长度不对也不报错)。
为什么起止符合并成一个 .
如果用两个符号,表就是 28×28。但起始符只出现在开头,永远不会作为「下一个字符」;结束符只出现在结尾,永远不会作为「当前字符」。所以会有一整行和一整列永远是 0。
合并成单个 . 后压缩成 27×27,而且没有全零行列。. 占 0 号位,所以字母从 1 开始:
stoi = {s: i+1 for i, s in enumerate(chars)}stoi['.'] = 0itos = {i: s for s, i in stoi.items()}两个推导式里的变量顺序不同,由数据源决定:
enumerate给(序号, 值)所以是for i, s;items()给(键, 值)所以是for s, i。写反不报错,但结果全错。
第一次用张量
N = torch.zeros((27, 27), dtype=torch.int32)for w in words: chs = ['.'] + list(w) + ['.'] for ch1, ch2 in zip(chs, chs[1:]): N[stoi[ch1], stoi[ch2]] += 1一个对象装 729 个数,而不是 729 个 Value —— 这是从标量思维转向张量思维的起点。
为什么要换掉字典:字典能存数据,但做不了整体运算(要归一化得写循环),也无法可视化。
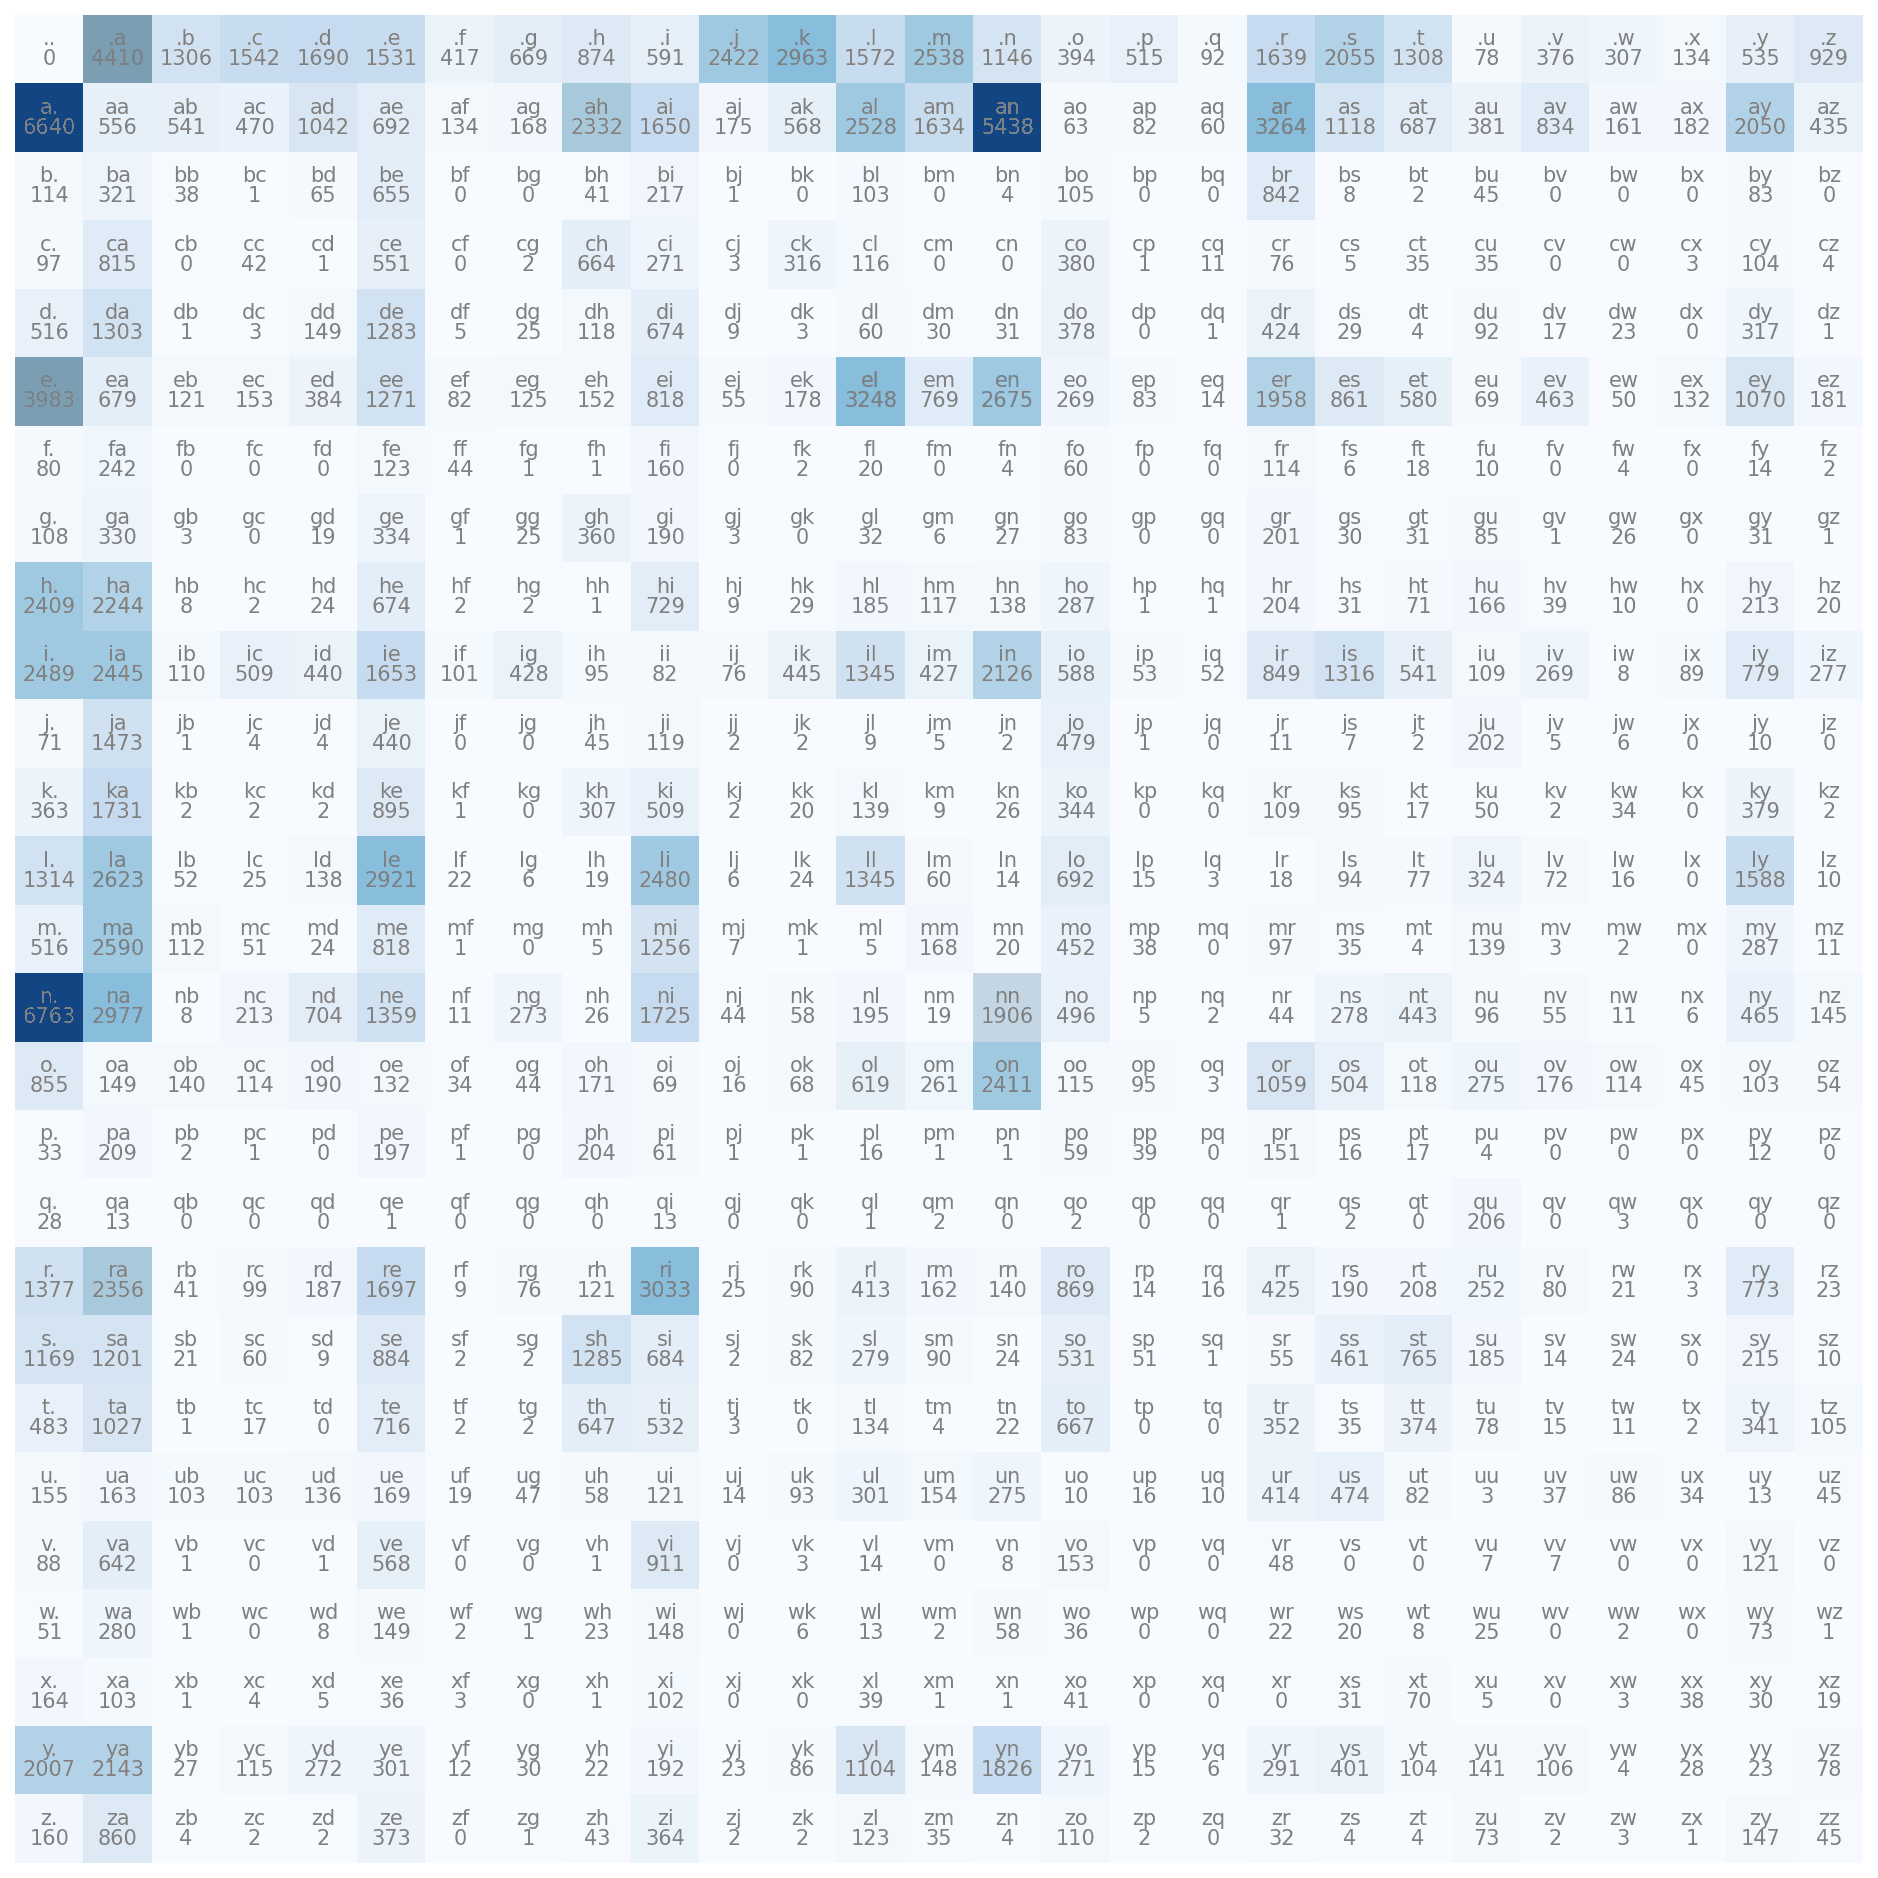
从图上能直接读出的规律:
| 位置 | 含义 | 看到什么 |
|---|---|---|
第 0 列(x → .) | 以什么结尾 | n. 6763、a. 6640、e. 3983 |
第 0 行(. → x) | 以什么开头 | .a 4410、.k 2963、.m 2538 |
| 最深的几格 | 高频组合 | an 5438、ar 3264、el 3248 |
q 那一整行 | 几乎全白 | 只有 qu = 206,其余几乎全 0 |
左上角 .. | 0 | 空名字不存在 |
理论上限 729 种组合,实际出现 627 种 —— 缺 102 种。 这 102 个零后面会成为一个真问题。
采样:模型第一次「造」东西
g = torch.Generator().manual_seed(2147483647)ix = torch.multinomial(p, num_samples=1, replacement=True, generator=g).item()multinomial 的原理是轮盘赌:把概率排成一条线段,每段长度 = 该项概率,然后在 0—1 之间取一个均匀随机数,看它落在哪一段。段越长越容易被砸中。
手写版本就是:
def pick(p, r): cum = 0.0 for i, prob in enumerate(p): cum += prob if r < cum: return i随机数是唯一的不确定性来源。 给定
p和r,答案完全确定 —— 没有「二次随机」。所以固定种子后重跑,生成的名字完全相同。链条是:种子固定 → r 序列固定 → 每次抽签结果固定 → 名字固定。
为什么不能取最大值:p.argmax() 永远返回同一个,模型只会生成一个名字,而且是死循环。抽签才有多样性 —— 这也是 GPT 每次回答不同的原因。
生成循环:
ix = 0 # 从 . 出发while True: p = P[ix] # 查第 ix 行的分布 ix = torch.multinomial(p, 1, generator=g).item() if ix == 0: break # 抽到 . 结束 out.append(itos[ix])ix 的自我更新和第五篇 MLP.__call__ 里 x = layer(x) 是同一个套路 —— 上一步的输出成为下一步的输入。
生成结果:cexze、momasurailezitynn、konimittain、llayn、ka。
看着像名字,但都不是真名字。 对照完全均匀随机的 hjqzxvbn,bigram 虽然短视,确实学到了东西。质量不高是因为只看前一个字符 —— 生成 momasurai 中间那个 m 时,模型完全不知道前面已经有了什么。这就是上下文只有 1 的代价。
广播与 keepdim:本节最大的坑
P = N.float()P /= P.sum(1, keepdim=True)dim 指的是「哪一维被消掉」,这点反直觉:
| 写法 | 消掉哪维 | 结果形状 | 直观理解 |
|---|---|---|---|
A.sum(0) | 第 0 维(行) | (3,) | 每列的和 |
A.sum(1) | 第 1 维(列) | (3,) | 每行的和 |
keepdim 是 keep dimension —— 求和后那一维要不要留着(长度变成 1)。数值完全相同,区别只在形状:A.sum(1) 是 (2,),A.sum(1, keepdim=True) 是 (2, 1)。
广播规则是右对齐,1 在哪就沿哪复制。 用 3×3 举例,行和是 10、100、10:
正确版 (3,1) 是竖着一列,横向复制,每行都除以自己的行和 → 每行和为 1.0 ✓
错误版 (3,) 会在左边补 1 变成 (1,3),横着一行,纵向复制,于是每一列都除以同一个数 → 每行和变成 0.91、8.2、0.73 ✗
错误的本质是分母的下标从 i 变成了 j:
正确: P[i][j] = N[i][j] / rowsum[i]错误: P[i][j] = N[i][j] / rowsum[j]这个 bug 不报错。
(3,3)和(3,)恰好能广播成功,PyTorch 认为你就是想这么算。唯一的防线是养成检查习惯:print(P.sum(1))必须全是 1.0。
顺带把三种「乘法」理清:A * B 是元素级(对应位置相乘),A @ B 是矩阵乘法(行乘列求和),A.sum(dim) 是归约(沿某维求和,消掉那一维)。PyTorch 里的 / 不是数学上的矩阵除法(那是乘逆矩阵),而是逐元素除;广播只是「补齐形状」的手段,真正的运算还是逐元素。
loss = 2.4544
上一篇推过的三步,这里落地:
log_likelihood += torch.log(prob) # 第一步:连乘变累加nll = -log_likelihood # 第二步:加负号print(nll / n) # 第三步:除以样本数 → 2.4544为什么必须取对数:228146 个小于 1 的数连乘约等于 10⁻²⁹⁶⁰⁰⁰,而浮点下限是 10⁻³⁰⁸ —— 直接变 0。
为什么要除 N,三个理由:总和 56 万只说明样本多,说明不了模型好坏;不同大小的数据集要能横向比较;梯度不随批次大小剧烈变化,学习率不用跟着调。
翻译成困惑度:
| 模型 | loss | 相当于在几个里猜 |
|---|---|---|
| 完全随机 | log 27 = 3.30 | 27 |
| bigram | 2.4544 | 11.6 |
| 下一步的 MLP | 约 2.2 | 约 9 |
| 理想 | 0 | 1 |
loss 线性下降,候选数指数下降。 从 3.30 到 2.45 只降了 0.85,候选数却从 27 砍到 11.6,少了一半以上。这个直觉后面很有用:loss 从 2.0 降到 1.5(候选 7.4→4.5)是大改进,从 0.5 降到 0.45(1.65→1.57)就很小了 —— 同样降 0.05,在不同区间含义完全不同。
bigram 到不了更低的原因是只看前一个字符。看到 q 几乎确定下一个是 u(等效候选接近 1),看到 a 却可能跟很多字符(等效候选 15)。2.45 是所有位置平均下来的结果。
model smoothing:那 102 个零
试一个数据集里没有的组合:jq 从未出现过,概率 0,log 0 = -inf,loss 直接变无穷大。这就是上一篇那张对数图上「x 趋近 0 时垂直下坠」的实际后果。
解决办法是给所有计数加 k:
P = (N + k).float()P /= P.sum(1, keepdim=True)| k | loss | 等效候选 | 说明 |
|---|---|---|---|
| 0 | 最低 | — | 最准,但有 inf 风险 |
| 1 | 2.4544 | 11.6 | 折中,实际用这个 |
| 10 | 2.51 | 12.3 | 开始抹平规律 |
| 100 | 2.69 | 14.7 | 明显变差 |
| 1000 | 2.95 | 19.1 | 趋近随机 |
k 越大越差,是因为真实的高频组合被压低、低频的被抬高,分布趋于均匀。k 趋于无穷时概率全变成 1/27,loss 趋近 3.30。
这就是正则化的雏形。 k 控制的是「多相信数据 vs 多留余地」:k 小就完全拟合训练数据,可能过拟合;k 大就约束模型不让它太自信,牺牲训练 loss 换泛化能力。
jq没出现过不代表绝不可能 —— k=1 相当于说「每种组合我都假设见过一次」。后面会看到,神经网络里的 L2 正则化和这个+k在数学上是同一件事。
第二条路:神经网络
统计法已经做出一个能用的语言模型。现在用神经网络 + 梯度下降重做一遍。
为什么要费这个劲,三个理由:扩展性 —— 统计法看 3 个字符就要 27⁴ 格的表,看 10 个是 27¹¹,怎么都填不满;灵活性 —— 统计法只能「数」,神经网络能加激活、加层数、换结构;还有本集要证明的事 —— bigram 这么简单的情况下两种方法结果几乎一致,说明神经网络不是魔法。
建训练集:从「遍历」到「样本对」
统计法直接遍历所有名字数数,神经网络需要明确的(输入, 标签)对:
xs, ys = [], []for w in words: chs = ['.'] + list(w) + ['.'] for ch1, ch2 in zip(chs, chs[1:]): xs.append(stoi[ch1]) ys.append(stoi[ch2])xs = torch.tensor(xs)ys = torch.tensor(ys)emma 产生 5 个样本:(., e)、(e, m)、(m, m)、(m, a)、(a, .),编号是 (0,5)、(5,13)、(13,13)、(13,1)、(1,0)。
和统计法遍历的是同一批 bigram,只是这次要显式存成两个张量。
tensor和Tensor的坑:torch.tensor([1,2,3])是 int64,保持整数;torch.Tensor([1,2,3])是 float32,强制转浮点。这里必须用小写 —— 索引得是整数,浮点数没法当下标。
one-hot 与单层网络
xenc = F.one_hot(xs, num_classes=27).float() # (N, 27)W = torch.randn((27, 27), generator=g)logits = xenc @ W # (N,27) @ (27,27) = (N,27)没有隐藏层、没有偏置、没有激活函数 —— 就一个矩阵乘法。这是最小的神经网络。形状上中间那个 27 消掉了。
W 的形状和统计法那张 27×27 的表尺寸相同 —— 这不是巧合。
两个必须写的参数:
num_classes=27,不指定的话 PyTorch 按数据里的最大值推断;.float(),因为one_hot返回 int64,后面要和浮点权重做矩阵乘法。另外
@是矩阵乘法(行乘列求和),*是元素级相乘,两者完全不同。
one-hot 乘矩阵 ≡ 查表
xenc[0] 是 [1,0,0,…,0],和 W 相乘:
[1,0,0,…] @ W = 1×W第0行 + 0×W第1行 + … = W第0行其余 26 行全被 0 乘掉了。 验证:torch.allclose(logits[0], W[xs[0]]) → True。
这就是 embedding 的动机。 词表 5 万时,one-hot 是 5 万维向量,矩阵乘法要算 5 万次乘法(其中 49999 次是乘 0)—— 而查表只要一次索引。这不是优化技巧,是必须的。
同样的道理在上一篇的交叉熵里已经出现过一次:
probs[target]等价于 one-hot 相乘再求和,只是省掉了 26 次乘 0。两处的本质是同一件事。
softmax:与统计法的结构对照
counts = logits.exp() # 第一步:变正数probs = counts / counts.sum(1, keepdim=True) # 第二步:归一化keepdim=True 又出现了 —— 和前面归一化 N 时是同一个道理。
把 counts 理解成「模型认为的计数」:
| 统计法 | 神经网络 | |
|---|---|---|
| 计数 | N(数出来的整数) | logits.exp()(算出来的正数) |
| 概率 | N / N.sum(1, keepdim) | counts / counts.sum(1, keepdim) |
归一化那一步完全相同,区别只在于计数从哪来。exp 的作用正是把任意实数变成合法的计数 —— 计数必须为正,而 logits 可正可负。
训练要做的事:调整
W,让「算出来的计数」逼近「数出来的计数」。
loss 怎么算:没有「预期概率」可比
真实答案不是一个概率分布,而是一个确定的字符。数据集里 emma 的 e 后面就是 m,不是「70% 可能是 m」。
所以比较方式不是「两个分布相减」,而是一次查表 + 一个对数:
y = ys[i] # 正确答案的索引,比如 13p = probs[i, y] # 去那一行里把第 13 列取出来loss = -torch.log(p)| 真实值是什么 | 怎么比 | |
|---|---|---|
| 平方误差(V1) | 一个数 | 相减再平方 |
| 交叉熵(V2) | 一个类别 | 查出该类的概率,取 −log |
数值感(假设正确答案是 m):
| 模型的输出分布 | probs[i,13] | loss |
|---|---|---|
平均分散 [0.037]*27 | 0.037 | 3.30 |
押错了 a:0.9、m:0.01 | 0.01 | 4.61 |
押对了 m:0.9 | 0.90 | 0.11 |
中间那行最惨 —— 因为它自信地错了。这正是交叉熵的设计意图。
批量写法用高级索引,一次取出全部正确项:
loss = -probs[torch.arange(N), ys].log().mean()torch.arange(N) 是 [0,1,2,…],和 ys 按位置配对,等价于 probs[0, ys[0]]、probs[1, ys[1]]…… 两个等长的索引张量按位配对,没有循环。
一个实用的健康检查:
W是随机初始化的,所以初始 loss 应该在 log(类别数) 附近,也就是 3.30(实际会略高,约 3.5—4,因为随机的W会产生一些无意义的偏好)。如果高得离谱,通常是初始化有问题 —— 权重太大,模型一开始就自信地胡说。
训练循环:和 V1 一模一样
for k in range(300):    xenc = F.one_hot(xs, num_classes=27).float()    logits = xenc @ W    counts = logits.exp()    probs = counts / counts.sum(1, keepdim=True)    loss = -probs[torch.arange(num), ys].log().mean()
W.grad = None # 清零 loss.backward() W.data += -50 * W.grad # 更新| 第六篇手写版 | PyTorch 版 |
|---|---|
for p in n.parameters(): p.grad = 0.0 | W.grad = None |
loss.backward() | loss.backward() |
p.data += -0.05 * p.grad | W.data += -50 * W.grad |
三个细节:
requires_grad=True—— 默认张量不追踪梯度,得显式开启。这就是第四篇里手写的_prev/_backward,PyTorch 内置了W.grad = None而非= 0—— PyTorch 里设成None更高效,反向时会直接赋值而不是累加W.data而非W——.data绕过梯度追踪,不然这次更新本身也会被记进计算图
学习率为什么是 50(第六篇用的是 0.05,差了一千倍):梯度被 228146 个样本取了平均,摊薄了;而且单层线性的损失曲面平缓,大步子不会震荡。
两条路殊途同归
| 统计法 | 神经网络 | |
|---|---|---|
| 参数 | 27×27 计数表 N | 27×27 权重 W |
| 内容 | 计数(非负整数) | logits(任意实数) |
| 怎么得到 | 数出来 | 梯度下降训练出来 |
| 变概率 | 除以行和 | 先 exp 再除以行和 |
| loss | 2.4544 | 约 2.46 |
还可以直接比概率表:
Pcount = (N + 1).float(); Pcount /= Pcount.sum(1, keepdim=True)with torch.no_grad(): Pnet = (torch.eye(27) @ W).exp() Pnet = Pnet / Pnet.sum(1, keepdim=True)print('最大差异:', (Pcount - Pnet).abs().max().item())torch.eye(27) 是单位矩阵,每一行都是一个 one-hot,一次性得到全部 27 行 logits。
这回答了「神经网络到底在学什么」:它在逼近数据的统计规律。
而且这里有个真实项目里极其罕见的好事:统计法给出了这个任务的理论最优值。神经网络追平了它,说明训练完全到位,不是「还能再练练」。
那为什么还要用神经网络
| 上下文 | 表的格子数 | 统计法 |
|---|---|---|
| 1 个字符 | 27² = 729 | 能数,627 种真的出现过 |
| 3 个字符 | 27⁴ = 531,441 | 22.8 万条数据都填不满 |
| 5 个字符 | 27⁶ ≈ 3.87 亿 | 大部分格子是 0 |
| 10 个字符 | 27¹¹ ≈ 5.6×10¹⁵ | 完全不可能 |
数据再多也填不满那张表。 没见过的组合概率是 0,模型认为「绝不可能」—— 毫无泛化能力。
神经网络用固定参数量处理任意上下文。这就是它的全部价值。
采样策略是可调的
神经网络给出 27 个概率,multinomial 按概率抽一个,两者合起来才得到下一个字符。模型说的是「看到 a 之后,n 有 20% 可能、. 有 18%」,不是「一定是 n」 —— 因为数据本身就是多样的。
生成结果:junide、janasah、prelay、kohin、tolian。和统计法生成的具体名字不同(概率表有小数点后的微小差异,抽签会把差异放大),但风格一致:长度分布相似、元音辅音交替、结尾都是常见后缀。
| 策略 | 做法 | 效果 |
|---|---|---|
| greedy | 取最大 | 确定、保守、易重复 |
| temperature | logits 除以 T 再 softmax | T 小→保守,T 大→发散 |
| top-k | 只在前 k 个里抽 | 排除低概率的怪词 |
| top-p | 只在累积概率 p 内抽 | 动态截断 |
Pᵢ = e^(zᵢ/T) / Σⱼ e^(zⱼ/T)API 里那个 temperature 参数就是这个。 它改的是概率分布的形状,不是随机数本身。
模型的输出是分布,不是答案。 从分布到答案这一步叫采样,它是独立的、可调的。同一个模型配不同策略,行为可以差别很大。
smoothing 就是 L2 正则化
loss = -probs[torch.arange(num), ys].log().mean() + 0.01 * (W**2).mean()# └────────── 数据项 ──────────┘ └─── 正则项 ───┘两项方向相反:数据项要 W 尽量拟合数据,需要大权重来区分高低频;正则项要 W 尽量接近 0,不管数据长什么样。λ 决定谁的话语权更大。
为什么「W → 0」等于「分布均匀」:
W = 0 → logits = [0,…,0] → exp → [1,…,1] → 归一化 → [1/27, …]完全均匀分布,什么都没学到。 所以:
| 极端情况 | 结果 | |
|---|---|---|
| smoothing | k → ∞ | 计数全被垫平 → 均匀 |
| L2 正则 | λ → ∞ | W 全变 0 → 均匀 |
两者都是把分布往均匀方向拉,只是操作对象不同 —— 一个拉计数,一个拉权重。
从梯度上看更清楚。正则项对 W 的偏导是 2λ/729 · W,所以更新时相当于每轮把 W 乘上一个略小于 1 的数。这个操作叫 weight decay(权重衰减),PyTorch 优化器里有同名参数。
它是无条件的:不管数据说什么,每轮都往 0 拉一点。只有反复出现的规律能顶住这个拉力,偶然的噪声顶不住 —— 这就是它提升泛化的机制。
什么叫「训练到位」
loss = 0 在语言模型里既不可能也不该追求 —— 它意味着每个位置都 100% 确定,而 a 后面本来就可能是 n、.、r。这是数据的内在不确定性,不是模型缺陷。
三个判据:低于随机基线 3.30,说明至少学到了东西;接近同类模型的已知水平,bigram 的天花板就是 2.45;loss 曲线压平,再训 1000 轮也不动。
更重要的是验证集 —— 验证 loss 触底反弹的那一刻就该停。bigram 这里不用担心:参数只有 729 个而数据有 228146 个,模型没能力背下来。但往后参数会暴涨,这个判据就必须用上。
同一个 bigram 模型,数频次得到 2.4544,梯度下降得到 2.46。两条完全不同的路,几乎相同的终点 —— 神经网络不是魔法,它在逼近数据的统计规律。它的价值不在于「更准」,而在于「能扩展」。
V2 到此完结。新掌握的工具:张量与广播、keepdim 的坑、高级索引、multinomial 采样、softmax、交叉熵,以及 PyTorch 的 requires_grad / backward / .data。
下一步是 V3:上下文从 1 个字符扩到 3 个,loss 会从 2.45 降到约 2.2。会正式引入 embedding(今天那个「乘法等价于查表」的直接应用)、隐藏层、mini-batch 训练,以及训练 / 验证 / 测试集划分。