学习率该除以 3:四张图把「试出来」变成「算出来」
第十六篇结尾说,BatchNorm 把第十四篇那张诊断清单的前两级架空了:σ_W 差一千倍都无所谓,
饱和在现场被拉回。清单还剩什么?
往下推一级。 前两步现在是自动的,真正要看的是后面三张图, 而第四张给出的是整个诊断流程里唯一一个可以直接照做的动作。
四张图是怎么来的
四张图不是四段独立的代码 —— 前三张读的是同一次前向反向留下的三样东西,第四张是训练时一路记下来的。
所以先把来源说清楚:之前那份代码一样都拿不到,forward 只返回 logits,h、z 算完就扔。
先重构,才有得画。
先把网络换个形状
这个形状第五篇已经写过一遍了。那时候是在 Value 上搭 Neuron / Layer / MLP:
self.layers = [...]、for layer in self.layers: x = layer(x)、
parameters() 把每层的参数拍平收上来。这次是同一个形状换成矩阵版,不是新想法。
三个类,每个只管三件事:
| 方法 | 干什么 | 为什么需要 |
|---|---|---|
__init__ | 创建并保存自己的参数 | 每层管好自己的东西 |
__call__ | 前向计算,并把结果存进 self.out | 让 layer(x) 直接可调;四张图全靠这个 out |
parameters() | 报告自己有哪些参数 | 外面一行代码收齐 |
__call__ 第五篇点过:b(5) 就是 b.__call__(5) 的语法糖,PyTorch 的 nn.Module
也重载了它。这里只补一个当时没说的词 —— Tanh 明明没有参数,也得写 parameters():
class Tanh: def parameters(self): return []为的是让外面这行不用特判:
parameters = [C] + [p for layer in layers for p in layer.parameters()]这叫鸭子类型:Python 不看你是什么类,只看你能做什么。只要实现了 __call__
和 parameters(),就能塞进 layers。接口统一,收集才能一行写完。
网络长这样
⚠️ 这个网络的
n_hidden是 100,不是第十四到十六篇那个 200。 那三篇讲的是30 → 200 → 27的两层网络,这一篇是六层 ×100。 参数形状(30,100) / (100,100) / (100,27)只有这样,参数量才对得上 47024。
两处初始化调整:
with torch.no_grad(): layers[-1].gamma *= 0.1 # 输出层压小 → 初始 loss ≈ ln(27) for layer in layers[:-1]: if isinstance(layer, Linear): layer.weight *= 5/3 # tanh 的 gain第一行就是第十四篇那个「修正初始 loss」,只是换了作用点:之前改 W2 * 0.01,
现在最后一层是 BN,所以改它的 γ。
第二行解释了一件容易被当成疏漏的事 —— gain 为什么不写进 Linear.__init__。
类里只除 √fan_in,gain 留到建网络时统一乘。因为不同激活函数的 gain 不同
(tanh 是 5/3、ReLU 是 √2),类本身不该假设自己后面接的是什么。
两半合起来才是完整的 σ_W = gain / √fan_in。
四张图分别读哪个张量
| 图 | 读的是 | 什么时候记下来 | 形状 |
|---|---|---|---|
| ① 前向激活值 | layer.out,五个 Tanh 层 | 诊断那一格的前向 | (32, 100) |
| ② 反向梯度 | layer.out.grad,同样五层 | 同一次 backward | (32, 100) |
| ③ 参数梯度 | p.grad,七个二维张量 | 同一次 backward | (30,100)、(100,100)… |
| ④ update/data | 训练循环里每步记的 ud | 整个训练过程 | 20000 步 × 每步一组 |
前三张是同一次前向反向的三个切面 —— 所以它们必须在同一格里跑完再画,中间不能插别的。 第四张不一样,它得在训练循环里就开始记:
with torch.no_grad(): ud.append([((lr*p.grad).std() / p.data.std()).log10().item() for p in parameters])layer.out 这个字段就是上面那次重构换来的 —— 没有它,前两张图根本无从画起。
❗ 先记一个坑:evaluate 会把 layer.out 冲掉
一上来 layer.out.grad 全是 None,原因在这行:
print(f"train {evaluate(Xtr,Ytr):.4f} val {evaluate(Xdev,Ydev):.4f}")evaluate 内部又跑了一次 forward,把 layer.out 全部覆盖成新的 ——
而那次在 @torch.no_grad() 里,产生的张量不在计算图中,永远不会有 .grad。
这是 self.out 这种设计的固有坑:它记录的永远是「最后一次前向」,
任何中途调用 forward 的地方都会把它冲掉。PyTorch 用 hook 机制绕开,这里是简化版。
解法是诊断单独跑一格,训练循环里不加 retain_grad()(反正会被覆盖,还白占内存):
ix = torch.randint(0, Xtr.shape[0], (batch_size,))loss = F.cross_entropy(forward(Xtr[ix]), Ytr[ix])
for p in parameters:    p.grad = Nonefor layer in layers:    layer.out.retain_grad()      # ← 必须在 backward 之前loss.backward()
跑完这格立刻画图,中间不要再调 evaluate。
为什么要 retain_grad():W1.grad 这类参数梯度默认保存,而 ∂L/∂h 这类中间梯度
算完就扔 —— 因为没人会写 h.data += -lr * h.grad,它只是算出 ∂L/∂W1 的必经之路。
第十三篇手算反传、要把中间梯度打印出来核对时,用过一次这个开关。它就是 3B1B 说的那根接力棒:
本身不更新任何东西,但下一层要靠它继续往前推。
❗ no_grad 和 training=False 是两回事
第十一篇用过 @torch.no_grad() 写 evaluate,当时网络里还没有 BN,所以不构成问题。
现在有了,这两个开关必须分清:
| 控制什么 | |
|---|---|
torch.no_grad() | 要不要记计算图 —— 省内存和时间,不影响数值 |
layer.training = False | BN 用当前 batch 的统计量还是 running —— 直接影响结果 |
评估时两个都要。 只写 no_grad 不切 training,BN 会拿验证集自己的统计量去标准化
—— 等于让模型偷看了验证集的分布,结果会偏乐观。
实测
参数量 47024   层数 17     0/20000  loss 3.3298      ← 初始 loss 直接就在 ln(27) = 3.2958  5000/20000  loss 2.2419 10000/20000  loss 2.1913 15000/20000  loss 2.1039
train 2.1339   val 2.1531      耗时 40.8 秒
没有 hockey stick —— 模型从「诚实的无知」起步,没有拿前几百步去纠正初始化错误。 第十四篇那条曲线开头那一段陡降,这次没有。
| 模型 | 层数 | 步数 | val |
|---|---|---|---|
| 手调 0.2 | 2 | 13 万 | 2.0994 |
| BN + running | 2 | 13 万 | 2.1106 |
| 6 层 + BN | 6 | 2 万 | 2.1531 |
六层反而更差 —— 步数差 6.5 倍,而且 15000 步时 loss 还在往下走。
这一段的目的不是刷分,是建立结构。 有了 layer.out,四张图才画得出来。
图 ①:前向激活值
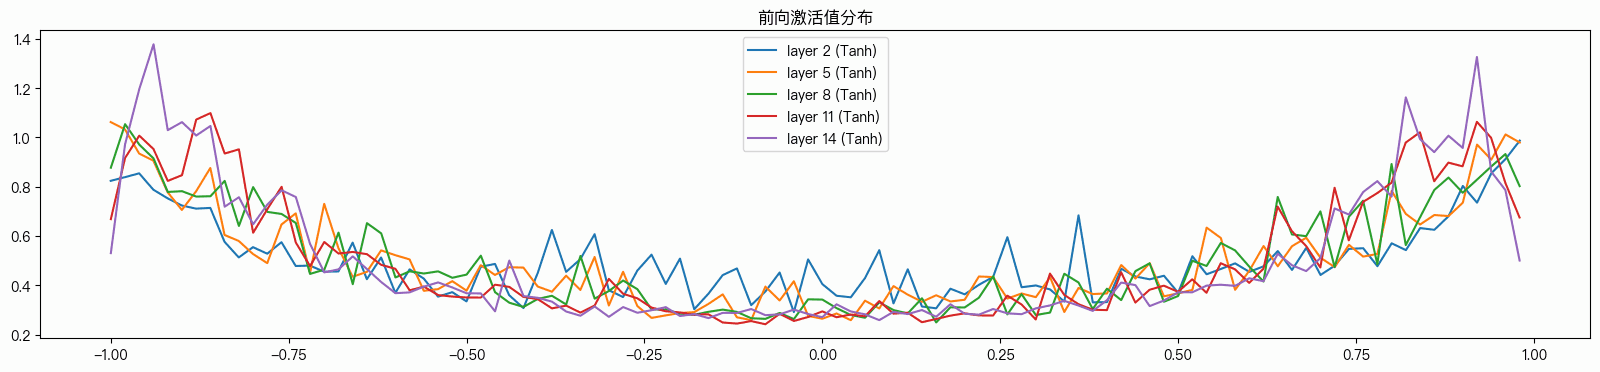
这张图画的是五个 Tanh 层的输出 h,横轴是 h 的取值(被 tanh 限死在 −1 到 1),纵轴是密度。
为什么用密度不用个数:五层要叠在一起比。如果某层维度不同,用「个数」画它天然矮一截,
比的就成了层大小而不是分布形状。密度 = 个数 ÷(总数 × 格宽),面积恒为 1。
换算一下:3200 个数、格宽 0.04,某格 160 个 → 密度 = 160 / (3200 × 0.04) = 1.25。
先读数字,再看图
layer 2 (Tanh): mean +0.00 std 0.64 saturated 5.4%layer 5 (Tanh): mean -0.01 std 0.66 saturated 6.2%layer 8 (Tanh): mean -0.01 std 0.67 saturated 5.4%layer 11 (Tanh): mean +0.00 std 0.68 saturated 4.3%layer 14 (Tanh): mean -0.01 std 0.69 saturated 3.5%这五行比图更快给出结论。 三列各回答一件事:mean 是中心在哪(该 ≈ 0)、
std 是散得多开(逐层不变最重要)、saturated 是多少比例学不动了(1—10% 算健康)。
mean 全是 0 是 BN 的功劳。tanh 是奇函数,均值偏在正半边等于只用了它的一半,
而 BN 的第一步就在强制拉回 0。那个 ±0.01 是抽样噪声。
⚠️ 每层比值是 1.019,不是 1.08
0.64 → 0.66 → 0.67 → 0.68 → 0.69,五层累计涨 8%。这个数对。
但五个值之间只有 4 次传递,所以每层比值是 (0.69/0.64)^(1/4) = 1.019,不是 1.08。
按 1.08 推 50 层会得到 48 倍,按 1.019 推是 2.6 倍:
| 每层比值 | 20 层后 | 30 层后 | 50 层后 |
|---|---|---|---|
| 0.6 | 3.7e−5 | 2.2e−7 | 信号没了 |
| 1.019(实测) | 1.46 | 1.76 | 2.56 |
| 1.5 | 3325 | 1.9e5 | 爆炸 |
结论没变 —— 看一眼 std 那一列,就知道这个架构能不能堆深,答案仍然是能。
但数字要写对,后面图②还要拿它做对照。
⚠️ 这一批数字是 0.97 口径
饱和是这么算的:
saturated = (t.abs() > 0.97).float().mean() * 100阈值是人定的。 第十四篇那一批用的是 0.99,这一段 Karpathy 换成了更严格的 0.97。
atanh(0.97) = 2.092,而 atanh(0.99) = 2.647 —— 同一个模型,换把尺子数字就变。
所以这一篇的 5.4% 不能和第十四篇的任何饱和数字直接比。
阈值本身选在哪,看的是梯度还剩多少:
| |h| | 1 − h² | 梯度剩多少 |
|---|---|---|
| 0 | 1.000 | 100% |
| 0.9 | 0.190 | 19% |
| 0.97 | 0.059 | 5.9% |
| 0.99 | 0.020 | 2% |
❗ 饱和不是越少越好
左边那格是关键:饱和 0%,但 σ_h / σ_z = 0.96 —— tanh 在这一段几乎就是恒等函数。
六层叠起来等价于一次矩阵乘,深度白加了。看到 0% 要反过来查 std,别以为越低越好。
这也正是 Kaiming 的目标是 σ = 1 而不是「越小越好」的原因。
中间那格的 σ_z = 1.10 给出 σ_h = 0.655、饱和 5.7%,和实测的 σ_h ≈ 0.65、5.4% 对得上。
U 形本身不是病,是 tanh 的必然结果:
z 的区间 | 宽度 | 映射到 h | 宽度 |
|---|---|---|---|
| −0.5 到 0.5 | 1.0 | −0.46 到 0.46 | 0.92 |
| 2 到 3 | 1.0 | 0.964 到 0.995 | 0.031 |
大的 z 被挤进 h 靠近 ±1 的一小段,那里密度自然高。关键是深浅
(下面这三个倍数是从直方图分箱量出来的,和上图解析算出的比例不是同一个量,不要并排比):
| 版本 | 两端 / 中间 | 饱和 |
|---|---|---|
| V4 最初 | ~50 倍 | 62.3% |
| 手调 0.2 | ~2.5 倍 | 1.4% |
| 现在 | ~4 倍 | ~5% |
还要分清两个说法
「5.4% 的激活值处于饱和」对;「5.4% 的神经元死了」不对。 同一个神经元对不同样本输出不同 —— 可能对样本 A 饱和、对 B 正常。真正死掉的是对所有样本都饱和的:
dead = (h.abs() > 0.97).all(0) # 沿样本方向全部为 True图 ②:反向梯度
和图①只差一个字:
t = layer.out.grad # 图 ① 是 layer.out这张图最容易卡在「
layer.out.grad全是None」上 —— 那个坑和它的解法 在上面「四张图是怎么来的」里已经说清楚了,诊断要单独跑一格。
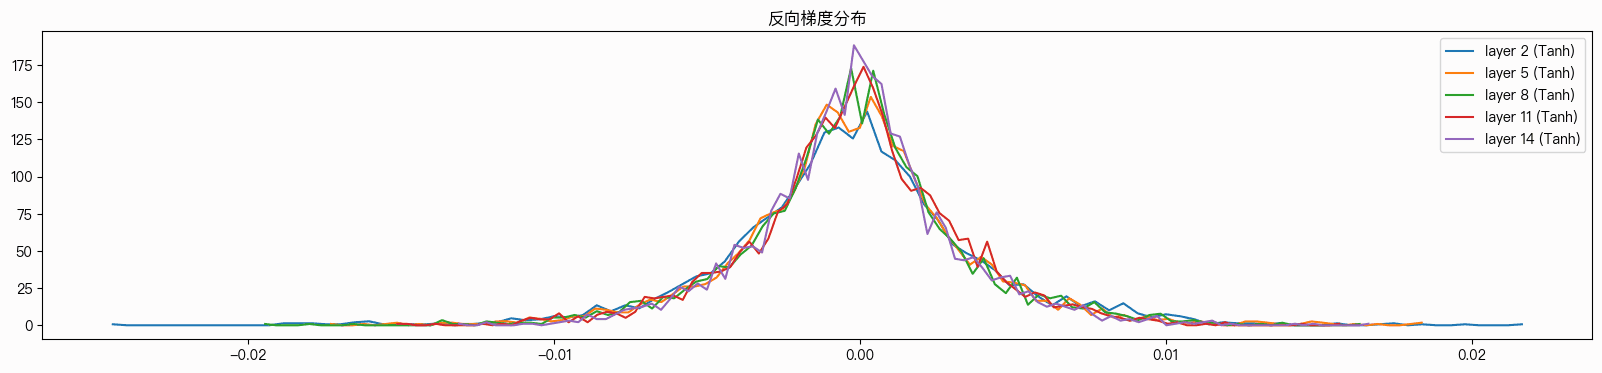
形状:钟形,不是 U 形
这是图②和图①最大的视觉差异,原因很直接:梯度没有边界限制。 它是自由的实数,不被 tanh 压缩,很多项相加,中心极限定理给出正态形状。 尖峰在 0 附近说明大部分位置梯度很小,只有少数位置需要大幅调整 —— 这是正常的。
顺带一提,横轴范围也差了 100 倍:图①是 −1 到 1,图②是 −0.02 到 0.02。梯度本来就是很小的数。
实测
layer 2 (Tanh): mean -0.000000 std 4.116130e-03layer 5 (Tanh): mean +0.000000 std 3.720852e-03layer 8 (Tanh): mean -0.000000 std 3.545590e-03layer 11 (Tanh): mean +0.000000 std 3.342206e-03layer 14 (Tanh): mean +0.000000 std 3.152745e-03五层全在 e-03,最大最小只差 1.3 倍。对照灾难性情况,梯度消失时两端能差 10 万倍。
注意方向反过来了:反向传播从 loss 往前走,起点是 layer 14(3.15e−3),终点是 layer 2(4.12e−3)。
每层比值 (4.12/3.15)^(1/4) = 1.069。
mean 精确为 0,比图①那个 ±0.01 更彻底 —— 梯度的正负是对称的,
有些样本要调大这个神经元、有些要调小,整体抵消。如果 mean 明显偏离 0,
说明所有样本都想往同一个方向推,通常意味着还有很大改进空间(训练早期会这样)。
⚠️ 两个方向都健康,但不是「几乎一样」
| 每层比值 | 20 层后 | 30 层后 | 50 层后 | |
|---|---|---|---|---|
| 前向(图①) | 1.019 | ×1.46 | ×1.76 | ×2.56 |
| 反向(图②) | 1.069 | ×3.79 | ×7.39 | ×28.0 |
两个都不爆炸也不消失,「这个 6 层网络可以堆到 20—30 层」成立。 但前向每层涨 1.9%、反向涨 6.9%,反向的漂移是前向的 3.6 倍, 说「两个方向几乎相同」是把「五层累计 8%」和「每层 6.9%」放在一起比了。
为什么图②比图①重要
| 衰减了会怎样 | 能补救吗 | |
|---|---|---|
| 前向信号 | 后面的层收到的信息弱 | 能 —— 后面的层可以放大回来 |
| 反向梯度 | 前面的层收不到更新信号 | 不能 —— 学不了就是学不了 |
梯度消失意味着前几层的参数永远停在初始值。这就是 2015 年之前深网络训不动的直接原因, 也是第十二篇提到的残差连接要解决的问题。
图 ③:参数梯度
前两张画的是层的中间结果,这张画的是参数本身的梯度 —— p.grad,
那个真正用来更新的东西:p.data += -lr * p.grad。
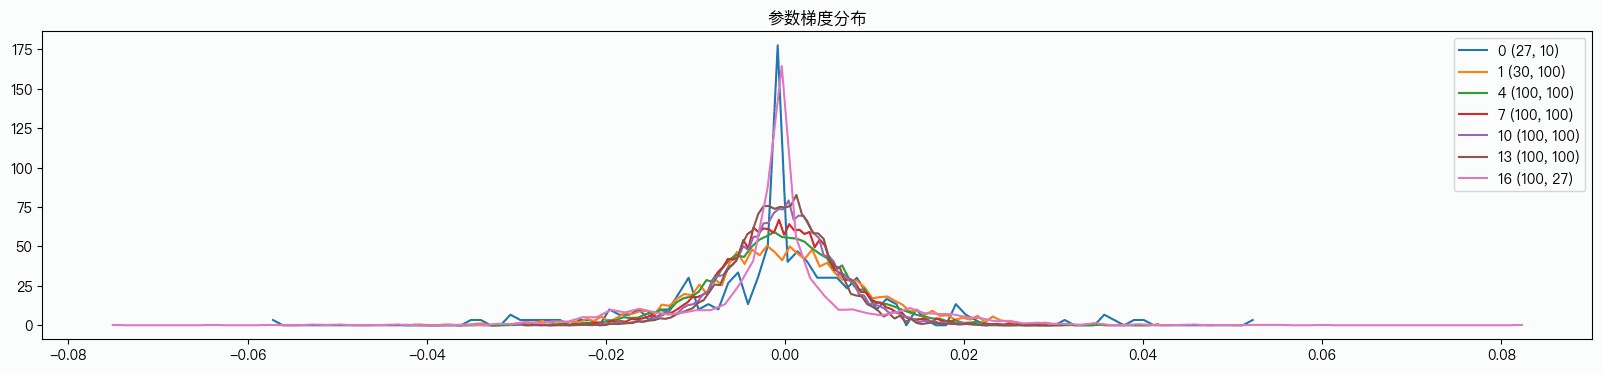
❗ 这是四张里唯一一张「图不如数字」的。 图上画的是梯度值的分布, 而这一节真正要读的是
grad/data—— 那是梯度 std 除以参数自身 std, 图上没有这个量,它在打印出来的那一列里。图的作用只剩一个:把C那根尖峰给你看见。
七个编号为什么跳着走
代码里只挑二维的:
if p.ndim == 2: # 只挑权重矩阵| 下标 | 形状 | 是谁 |
|---|---|---|
| 0 | (27, 10) | C 嵌入表 |
| 1 | (30, 100) | 第 1 层 Linear |
| 2, 3 | (100,) | 第 1 层 BN 的 γ、β ← 被跳过 |
| 4, 7, 10, 13 | (100, 100) | 第 2—5 层 Linear |
| 16 | (100, 27) | 输出层 Linear |
间隔 3 = 1 个 Linear 权重 + 2 个 BN 参数。 跳过 γβ 是因为它们是一维的、量级不同,混在一起看会乱。
❗ 看 grad/data,不看 std
ratio = σ(梯度) / σ(参数本身)读作:这个参数张量,每一步大约要被改动百分之几。
weight (27, 10) | std 1.194477e-02 | ratio 1.183552e-02weight (30, 100) | std 9.806189e-03 | ratio 2.992686e-02weight (100,100) | std 7.715235e-03 | ratio 4.201583e-02weight (100,100) | std 6.782562e-03 | ratio 3.722516e-02weight (100,100) | std 6.164674e-03 | ratio 3.422855e-02weight (100,100) | std 5.627475e-03 | ratio 3.148335e-02weight (100, 27) | std 1.065568e-02 | ratio 5.203685e-02看梯度 std:C 最大。看 ratio:C 最小。结论完全相反。
这就是要除一下的理由 —— 绝对的改动量没有意义,相对变化率才有。
中间四层非常整齐:4.20 → 3.72 → 3.42 → 3.15(×10⁻²),
四个 (100,100) 层量级完全一致,没有哪一层在狂奔或停滞。
两头偏离,各有各的原因
用 ratio = 梯度 std ÷ 参数 std 反推一下每个张量自身的 std,两头就清楚了:
| ratio | 反推的参数 std | 梯度 std | |
|---|---|---|---|
C 偏小 | 1.18e−2 | 1.009 | 1.19e−2(最大) |
| 中间四层 | ~3.5e−2 | ~0.181 | ~6e−3 |
| 输出层偏大 | 5.20e−2 | 0.205 | 1.07e−2 |
C 的 ratio 最小,主因是分母:C 是 randn 未缩放的,自身 std ≈ 1.0,
是中间层的 5.5 倍,而它的梯度只比中间层大约 2 倍,除完自然最小。
梯度稀疏(一个 batch 只碰到 27 行里的一部分,大量精确的 0)让分子没能涨得更多 ——
这正是第十三篇那张全是 0 和 1 的雅可比矩阵:∂L/∂C 只在被用到的行上非零。
⚠️ 输出层这一头,笔记给的第一个理由不成立。 笔记说它「被
gamma *= 0.1压小过,分母小」。但反推出来,输出层自身的std是 0.205, 是六个权重矩阵里最大的,不是最小的 ——gamma *= 0.1压的是 BN 的 γ,不是 Linear 的权重。 它 ratio 大是分子大:梯度std1.07e−2,是相邻那层的 1.89 倍。 第二个理由才是真的:它离 loss 最近,梯度天然更强。
病态会是什么样:某层 ratio 小 100 倍 = 那层几乎不学;大 100 倍 = 可能震荡发散; 逐层递减 = 梯度消失的参数版,这时候要回去修图②,调 lr 没用。
⚠️ 但图③只是一步的快照。 两万步里任何一步都可能是特例。
图 ④:update/data
前三张是快照,这张是整个训练过程的走势 —— 四张里最实用的一张。
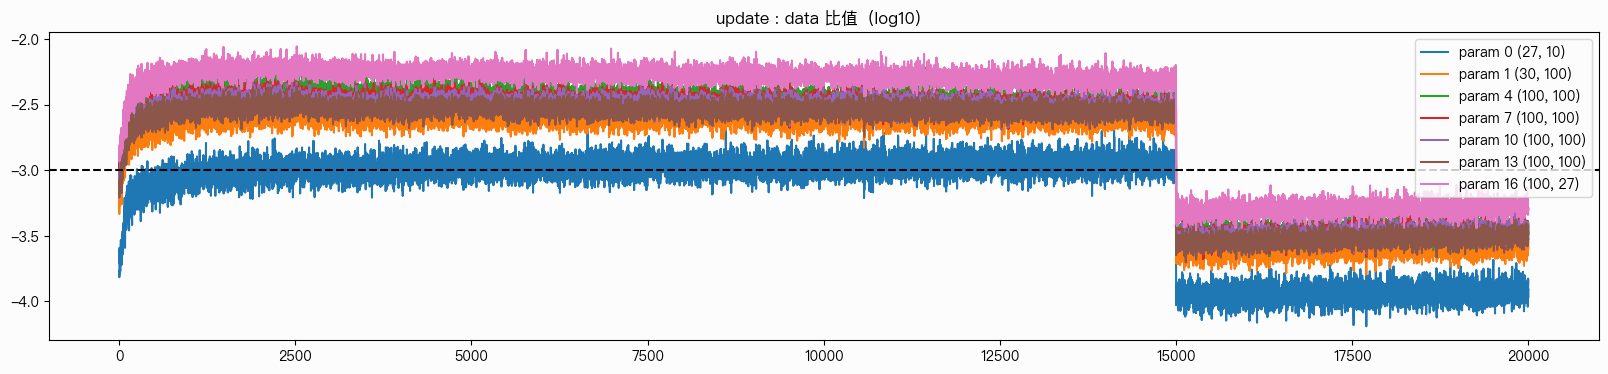
先说一件图上才看得见的事:七条都是带子,不是线。 每一步换一个 mini-batch, 比值本来就在抖,带子的厚度就是这个抖动。它也是一条诊断线索 —— 速查表里「抖动幅度突然变宽 = lr 过大」说的就是这个厚度,这里从头到尾没变宽。
公式里每个量是什么
纵轴 = log10( σ(lr × grad) / σ(data) )以 W1 为例:参数自身 std ≈ 0.33,这一步的梯度 std ≈ 9.8e−3,
乘上 lr = 0.1 得到实际改动量 ≈ 9.8e−4,比值 0.30%,取 log10 就是 −2.52。
为什么要除以 data:「改动 0.001」这个数本身没有意义,要看它相对参数自身有多大。
参数 std | 改动量 | 比值 | 判断 |
|---|---|---|---|
| 0.30 | 0.001 | 0.33% | ✅ |
| 0.001 | 0.001 | 100% | ❌ 一步翻倍,要炸 |
| 100 | 0.001 | 0.0001% | ❌ 一万步才动 1% |
为什么取 log10:三个理由,最后一个才是关键。跨几个数量级时线性坐标下
0.0001、0.001、0.01 全挤在一起;经验值 1e-3 变成一条整数线 -3,直接 axhline(-3);
而乘除变加减 —— lr ÷ 10 在图上就是整齐跌 1 格。这和第十一篇那个对数扫描是同一个道理:
倍数关系在对数坐标下变成等距。
四个阶段
| 阶段 | 位置 | 解释 |
|---|---|---|
| 0—2500 步 | 从约 −3.8 爬到 −2.5 | 初始 gamma *= 0.1 压小了输出,梯度也小;随着模型开始学,比值爬到稳定水平。图上这一段几乎全发生在前几百步,之后只是慢慢抬到位 |
| 2500—15000 | 稳定在 −2.5 | ✅ 平稳 |
| 15000 步 | 整齐跌 1 格 | lr 从 0.1 降到 0.01 |
| 15000—20000 | 稳定在 −3.5 | ⚠️ 偏低 |
七条线在衰减前的位置:输出层 −2.35、中间四层 −2.4~−2.5、第一层 −2.6、
C 在 −2.95,正好压在基线上。
图④ 就是图③ 乘上 lr
这句话可以直接对账。把图③的 ratio 乘上 lr = 0.1 再取 log10:
| 参数 | 由图③ 推出 | 图④ 实际位置 |
|---|---|---|
C | −2.93 | −2.95 |
| 第一层 | −2.52 | −2.60 |
| 中间四层 | −2.38 … −2.50 | −2.4 ~ −2.5 |
| 输出层 | −2.28 | −2.35 |
逐条吻合,最大差 0.08 —— 而图③是某一步的快照、图④是整段的水平, 这个量级的差正是应该有的。七条线的位置差异完全来自分母,和图③的 ratio 是同一件事。
三层判定:走势 > 位置 > 层间差距
先看走势。 启动爬升后平稳,或者一直平稳,都是 ✅。 持续上漂说明参数在缩小或梯度在变大,要失控;持续下沉说明学习在停滞; 非 lr 衰减的突然跳变则是有异常。
再看位置,相对 −3 这条基线:
| 偏离 | 倍数 | 判断 | lr 该乘几 |
|---|---|---|---|
| ±0.3 以内 | 0.5~2 | ✅ 理想 | 不用改 |
| ±0.3~0.7 | 2~5 | 可接受(本次) | 可选微调 |
| 高 0.7~1.5 | 5~30 | ⚠️ 偏大 | ÷ 10^(偏离量) |
| 低 0.7~1.5 | 5~30 | ⚠️ 偏小 | × 10^(偏离量) |
| 超过 ±1.5 | 30 倍以上 | ❌ 明确有问题 | 先回去查图①② |
最后看层间差距。 本次跨度是 −2.35 到 −2.95,0.60,也就是不到 10 倍,健康。
跨度超过 2(100 倍)时要单独调那一层的初始化,不是调全局 lr。
补上第十一篇的缺口
第十一篇学对数学习率扫描时,结论是一句很硬的限制:「它的价值是排除,不是选优。」 U 形曲线有历史依赖,只能把范围从 ×1000 压到 ×40 就到头了。
update/data 补的正是这一段:
新 lr = 旧 lr × 10^(−3 − 当前位置)当前 −2.5,目标 −3,代进去就是 × 10^(−0.5) = ÷ 3.2。
从「试出来」变成「算出来」。 扫描曲线负责粗筛,这个比值负责精调。
这张图给出的行动项
前三张全绿,第四张是唯一给出动作的:前段偏高 0.5,而且衰减跨度太大。
lr = 0.05 if step < 15000 else 0.02 # 两段都更贴近 -3# 或者平滑衰减lr = 0.1 * (0.1 ** (step / max_steps))衰减后停在 −3.5,意味着每步只把参数改动 10^(−3.5) ≈ 0.032%,
而衰减前是 10^(−2.5) ≈ 0.32% —— 后 5000 步干的活,大约相当于之前的 500 步。
loss 在最后那段几乎不动,原因就在这儿:0.1 直接砍到 0.01,跨度太大。
🔑 这正是这套工具该有的样子:不是告诉你「模型好不好」,而是告诉你下一步该调什么。
诊断手册
四张图读完,把结论压成一页,调模型时直接查:
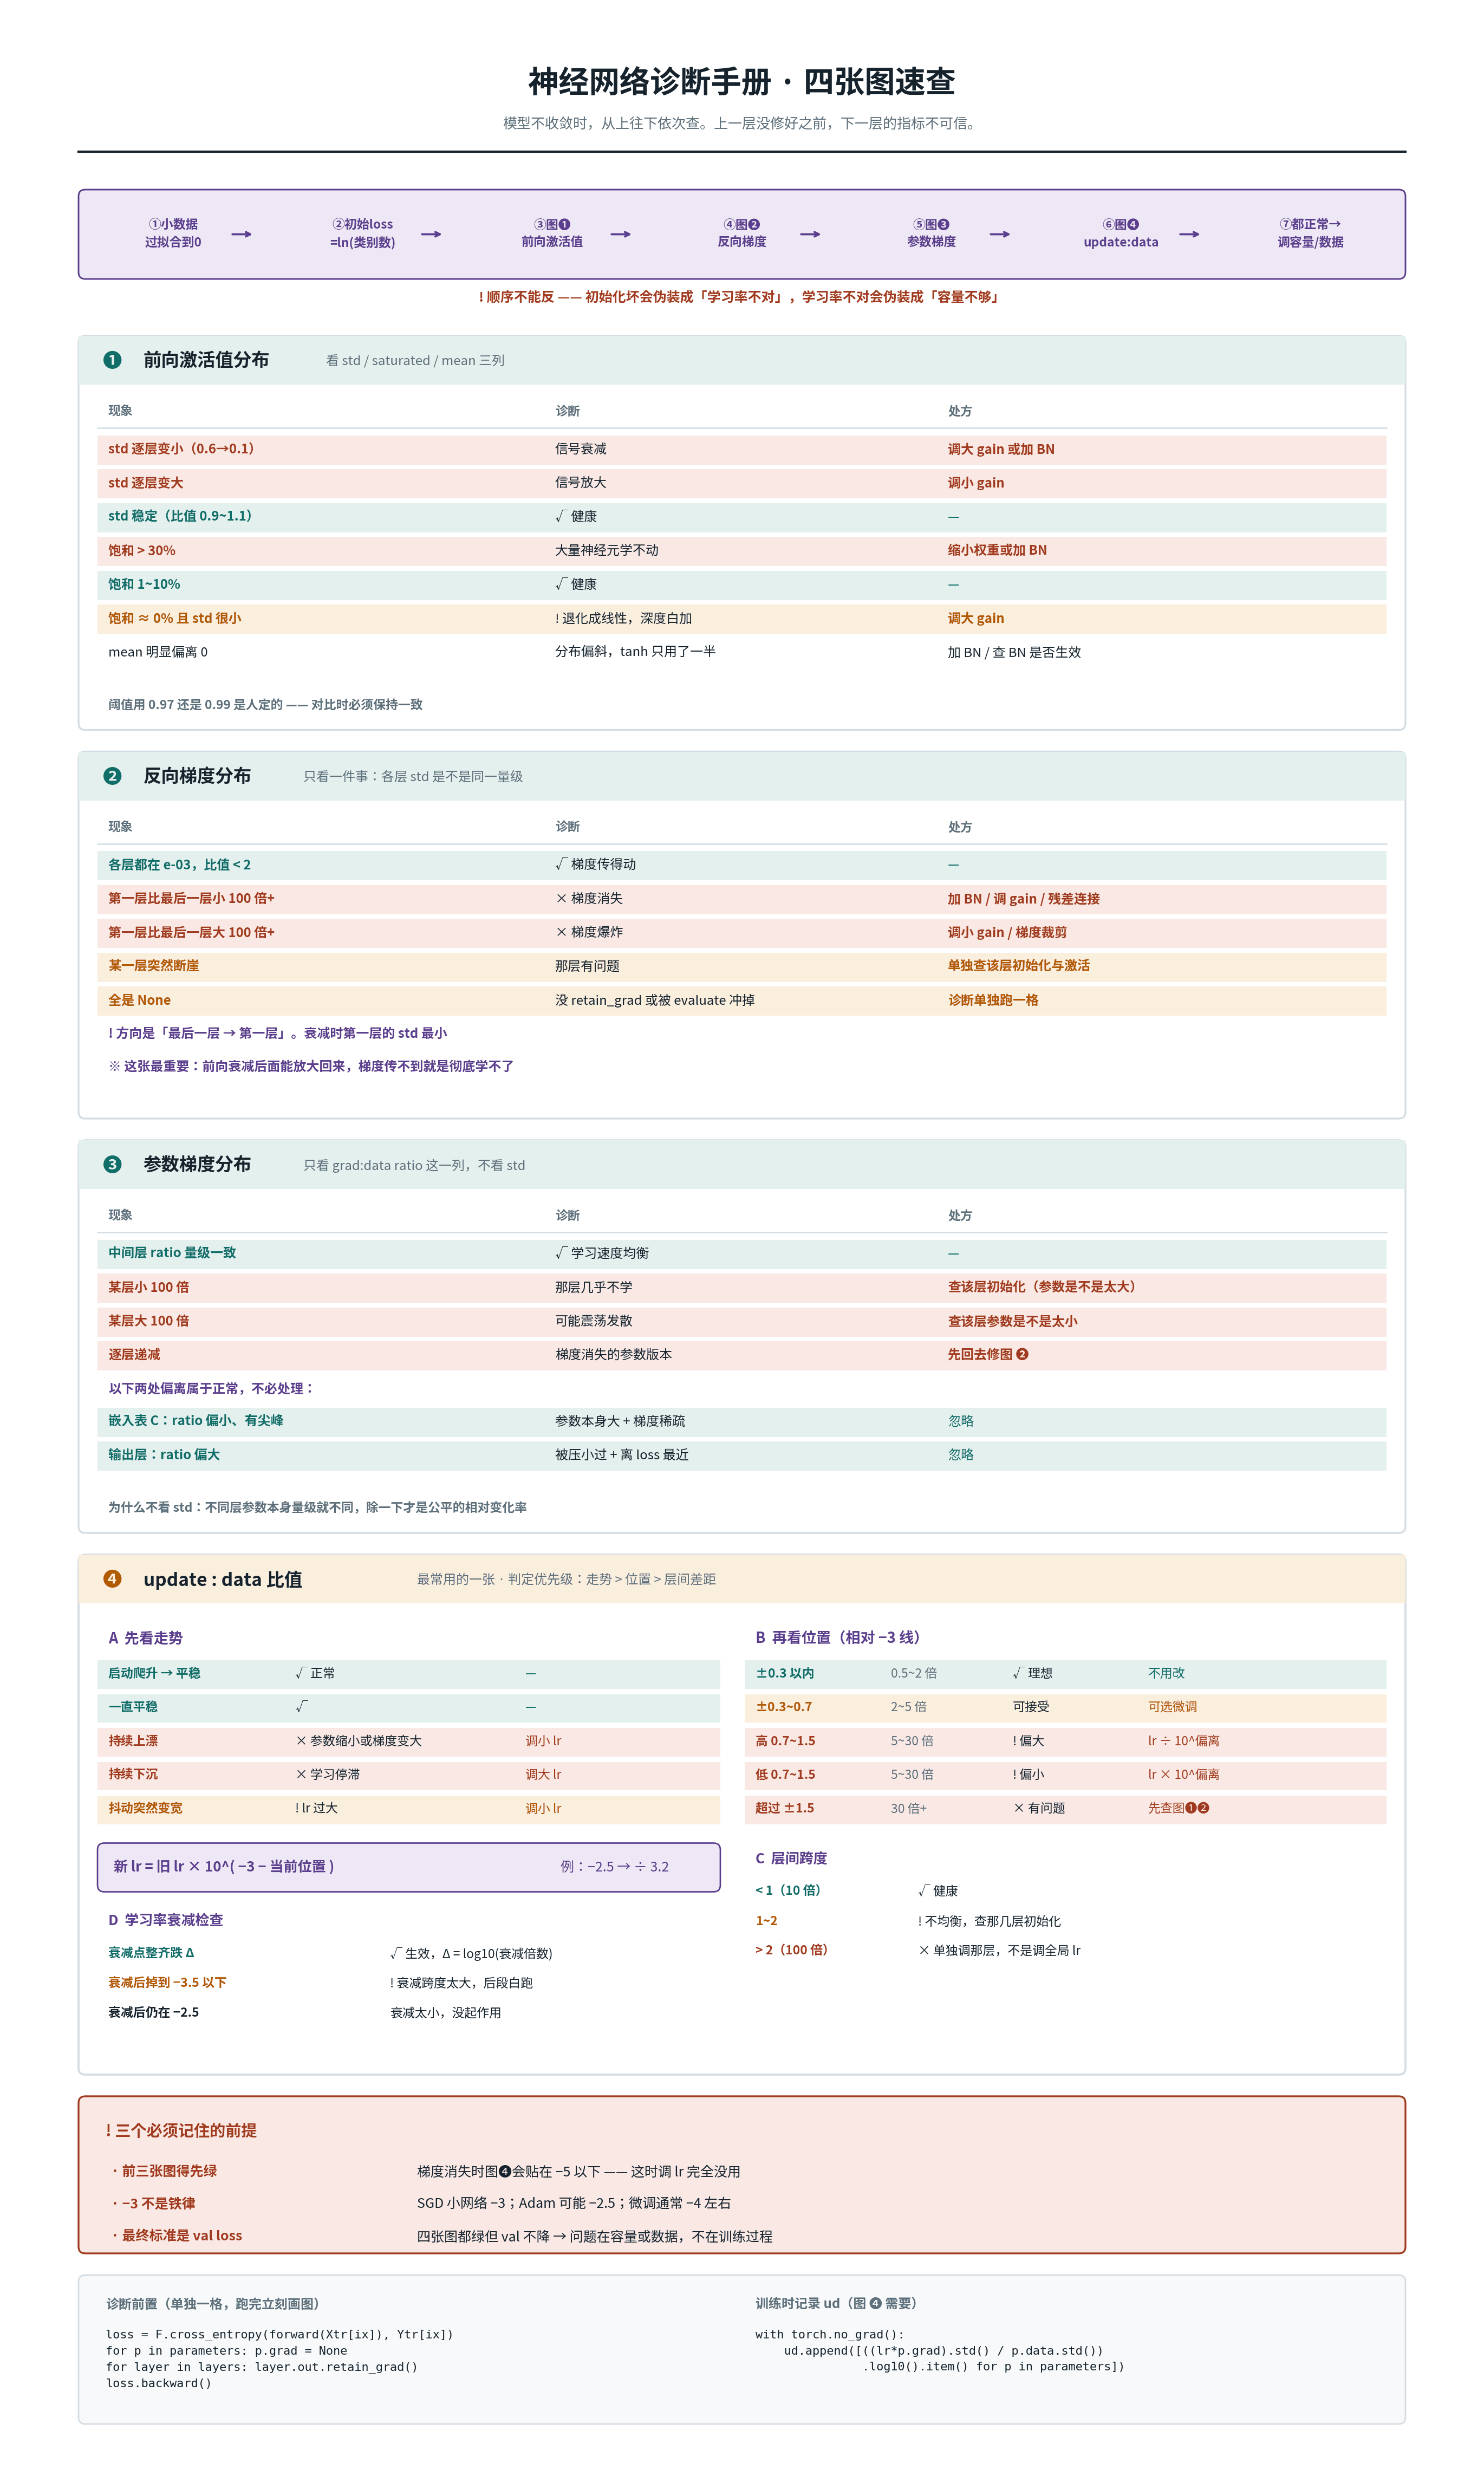
海报顶部那条流程就是第十四篇那张查错顺序,这里不重讲;下面按图逐张展开, 补的是第十四篇没有的部分:每张图具体看什么。
图① 前向激活值
看三个数:std、saturated、mean。
| 现象 | 诊断 | 处方 |
|---|---|---|
std 逐层变小(如 0.6→0.1) | 信号衰减 | 调大 gain 或加 BN |
std 逐层变大 | 信号放大 | 调小 gain |
std 稳定(比值 0.9~1.1) | ✅ | — |
| 饱和 > 30% | 大量神经元学不动 | 缩小权重或加 BN |
| 饱和 1~10% | ✅ | — |
饱和 ≈ 0% 且 std 很小 | ⚠️ 退化成线性,深度白加 | 调大 gain |
mean 明显偏离 0 | 分布偏斜,tanh 只用了一半 | 加 BN,或检查 BN 是否生效 |
图② 反向梯度
只看一件事:五层 std 是不是同一量级。 方向是 layer 14 → layer 2,
衰减的话第一层(layer 2)的 std 最小。
| 现象 | 诊断 | 处方 |
|---|---|---|
各层都在 e-03,比值 < 2 | ✅ 梯度传得动 | — |
| layer 2 比 layer 14 小 100 倍以上 | ❌ 梯度消失 | 加 BN / 调 gain / 加残差连接 |
| layer 2 比 layer 14 大 100 倍 | ❌ 梯度爆炸 | 调小 gain / 梯度裁剪 |
| 某一层突然断崖 | 那层有问题 | 单独查那层的初始化和激活 |
全是 None | 没调 retain_grad(),或被 evaluate 冲掉 | 诊断单独跑一格 |
图③ 参数梯度
只看 grad/data 那一列,不看 std。
| 现象 | 诊断 | 处方 |
|---|---|---|
| 中间层 ratio 量级一致 | ✅ 学习速度均衡 | — |
| 某层小 100 倍 | 那层几乎不学 | 查那层参数是不是太大 |
| 某层大 100 倍 | 可能震荡发散 | 查那层参数是不是太小 |
| 逐层递减 | 梯度消失的参数版 | 先回去修图② |
两个可以忽略的偏离:嵌入表 C 的 ratio 偏小、直方图有尖峰(参数本身大 + 梯度稀疏);
输出层的 ratio 偏大(离 loss 最近)。
图④ update/data
三层判定按优先级:走势 > 位置 > 层间差距,三张表在上一节。这里只补衰减检查:
| 现象 | 含义 |
|---|---|
| 衰减点整齐跌 ∆ | ✅ 生效,∆ = log10(衰减倍数) |
| 衰减后掉到 −3.5 以下 | ⚠️ 衰减跨度太大,后段白跑 |
| 衰减后仍在 −2.5 | 衰减太小,没起作用 |
❗ 三个必须记住的前提
| 前提 | 说明 |
|---|---|
| 前三张图得先绿 | 梯度消失时图④会贴在 −5 以下,这时候调 lr 没用 |
| −3 不是铁律 | SGD 小网络 −3;Adam 可能 −2.5;微调通常 −4 左右 |
| 最终标准是 val loss | 四张图都绿但 val 不降 → 问题在容量或数据,不在这四张图上 |
可以直接抄的代码
诊断前置,单独一格,跑完立刻画图:
ix = torch.randint(0, Xtr.shape[0], (batch_size,))loss = F.cross_entropy(forward(Xtr[ix]), Ytr[ix])for p in parameters: p.grad = Nonefor layer in layers: layer.out.retain_grad()loss.backward()训练时记录 ud(图④需要):
with torch.no_grad(): ud.append([((lr*p.grad).std() / p.data.std()).log10().item() for p in parameters])不画图,一键扫一眼四组数字:
print("—— 图① 前向激活 ——")for i, l in enumerate(layers[:-1]):    if isinstance(l, Tanh):        t = l.out        print(f"  {i:>2} std {t.std():.3f}  饱和 {(t.abs()>0.97).float().mean()*100:.1f}%")
print("—— 图② 反向梯度 ——")for i, l in enumerate(layers[:-1]):    if isinstance(l, Tanh):        print(f"  {i:>2} std {l.out.grad.std():e}")
print("—— 图③ 参数梯度 ——")for p in parameters:    if p.ndim == 2:        print(f"  {str(tuple(p.shape)):<12} ratio {p.grad.std()/p.std():e}")
print("—— 图④ update/data ——")for i, p in enumerate(parameters):    if p.ndim == 2:        print(f"  param {i:>2} 最后一步 {ud[-1][i]:+.2f}")
还没做的两件事
V4 到此完结。两项对照实验留着,这里照实记下,不替它们补结论:
gain改成 0.5 跑一遍,看病态的四张图长什么样 —— 现在只见过健康的, 没有对照就说不上「会读」- 按图④的建议重调学习率(
0.05 / 0.02),看 val 能不能降到 2.1531 以下 —— 这是把「算出来」这句话真正兑现的一步
从第十四篇到这一篇,V4 这四篇讲的是同一件事的四个侧面: 先知道要量什么(三个指标),再知道怎么让它自动成立(BatchNorm), 最后知道怎么把量出来的东西读成一个动作。
前三张图的价值是让第四张可信 —— 梯度都传不到的时候,调学习率是在调一个不存在的问题。